Как узнавать о сбое сайта раньше клиента: мониторинг сайта
Тому, кто сам поддерживает сайт, CRM или бота на VPS
Три уровня проверки и порядок реакции на сигнал
8 мин
Главная страница открывается у владельца, но заявка или бот давно не работают
Внешняя проверка и рабочие сигналы показывают сбой до жалобы клиента
Как настроить внешний запрос, проверку службы и рабочих событий, чтобы узнавать о сбое сайта и видеть его причину.
Мониторинг сайта начинается с определения, что для человека означает «работает». Ответ главной страницы проверяет только доступность одной страницы. Клиенту может требоваться форма заявки, расписание, личный кабинет или ответ бота. Я делю проверку на три уровня: сайт виден снаружи, процессы на сервере живы, важное действие доходит до результата. Так можно быстрее понять причину сообщения о сбое и не путать недоступность страницы с остановкой фоновой задачи.
На моём сайте patrikkyn.ru Next.js работает за nginx, служба управляется systemd и слушает локальный адрес 127.0.0.1. Это конкретная схема из проекта. Для другого сайта сначала выясните его собственные службы и маршруты. Для системы вроде Deyvo одной веб‑проверки недостаточно: там есть FastAPI, база и Telegram-бот с утренней и вечерней сводками. Мониторить нужно обещанное пользователю действие вместе с входной страницей. Про выбор состава VPS я пишу отдельно.
Что проверять снаружи сервера
Внешний наблюдатель должен регулярно обращаться к публичному адресу и сообщать, если ответ не пришёл либо вернулся ошибочный статус. Проверка с того же VPS не видит полную картину: сервер может быть недоступен из интернета, пока локальный запрос успешно отвечает. Для российского сайта выбирайте точку проверки, близкую к аудитории, и периодически проверяйте страницу в мобильной сети. Внешний сторож сообщает о симптоме; причина выясняется по серверу.
Следите за той страницей, которая нужна клиенту. Если главная статична, а форма лежит на другом маршруте, проверьте и его. При этом обычный GET не должен создавать настоящую заявку. Для проверки отправки используйте отдельный тестовый сценарий, который умеет удалять пробные данные и не тревожит менеджера. Если такого сценария нет, не подменяйте его ложным числом «всё работает» после ответа главной.
curl -fsS --max‑time 10 -o /dev/null -w '%{http_code}\n' https://patrikkyn.ru/
curl -fsS --max‑time 10 -o /dev/null -w '%{http_code}\n' https://patrikkyn.ru/stati
Это разовые диагностические команды. Адрес /stati/ перенаправляет на /stati с кодом 308, поэтому здесь указан конечный путь. Для непрерывного наблюдения нужен внешний сервис или отдельный процесс, который повторяет запросы и отправляет уведомление. Выбирайте канал, который реально читает ответственный человек ночью и в выходной. Письмо на редко открываемый адрес формально создаёт сигнал, но практически не помогает.
На моём сайте deploy.sh после выкладки запрашивает /, /cases, /cases/laser, /sitemap.xml и /robots.txt. Если любой из маршрутов отвечает не 200, скрипт останавливается и подсказывает посмотреть journalctl. Это проверка доставки новой версии по важным страницам; внешний сторож затем продолжает проверять доступность между выкладками.
| Уровень | Что обнаруживает | Чего не видит |
|---|---|---|
| Внешний HTTP | Сайт недоступен или отдаёт ошибку | Успешность заявки |
| Служба и журнал | Процесс упал или пишет ошибки | Проблему внешнего маршрута |
| Рабочее событие | Заявка, запись или сводка не дошла | Причину без дополнительного журнала |
Что смотреть внутри VPS после сигнала
Когда внешний сигнал пришёл, проверьте состояние службы, последние ошибки и свободное место. Не начинайте с перезапуска: он может скрыть полезную последовательность событий. На моём сайте служба называется malyshev; в своём проекте замените имя на фактическое. Если у вас нет доступа к systemd, используйте журнал своего способа запуска.
systemctl is‑active malyshev
journalctl -u malyshev -n 80 --no‑pager
df -h
ss -ltn
ss -ltnH | grep -vE "127.0.0.1|::1"
systemctl show malyshev -p User
npm audit --omit=dev --audit-level=high
Эти команды только читают состояние. ss с фильтром оставляет адреса, которые могут слушать снаружи; сверьте их с правилами сервера. systemctl show показывает пользователя службы, а npm audit проверяет производственные зависимости. Секреты и персональные данные в журнале не публикуйте. После проверки процесса посмотрите nginx: он может отдавать ошибку, хотя приложение здорово, или отдавать старую страницу из кеша. Для случая «пользователь не видит новую версию» отдельно сверяют сборку, доставку файлов, ответ сервера и кеширующий слой. Этот путь разобран в статье о выкладке сайта.
Как заметить сбой фоновой работы
Сайт может отвечать 200, а утреннее сообщение не прийти. Для бота и очереди задач нужен контроль события: когда оно должно было произойти, когда произошло фактически и сколько ошибок осталось в очереди. В Deyvo бот присылает сводку дня в 8:00 и зовёт на вечернюю рефлексию в 21:00. Снимок показывает пользовательский путь; проверка доставки должна сверять время последнего успешного сообщения по разрешённому тестовому аккаунту. Пробные сообщения не отправляют настоящим клиентам.
Как это выглядит в работе
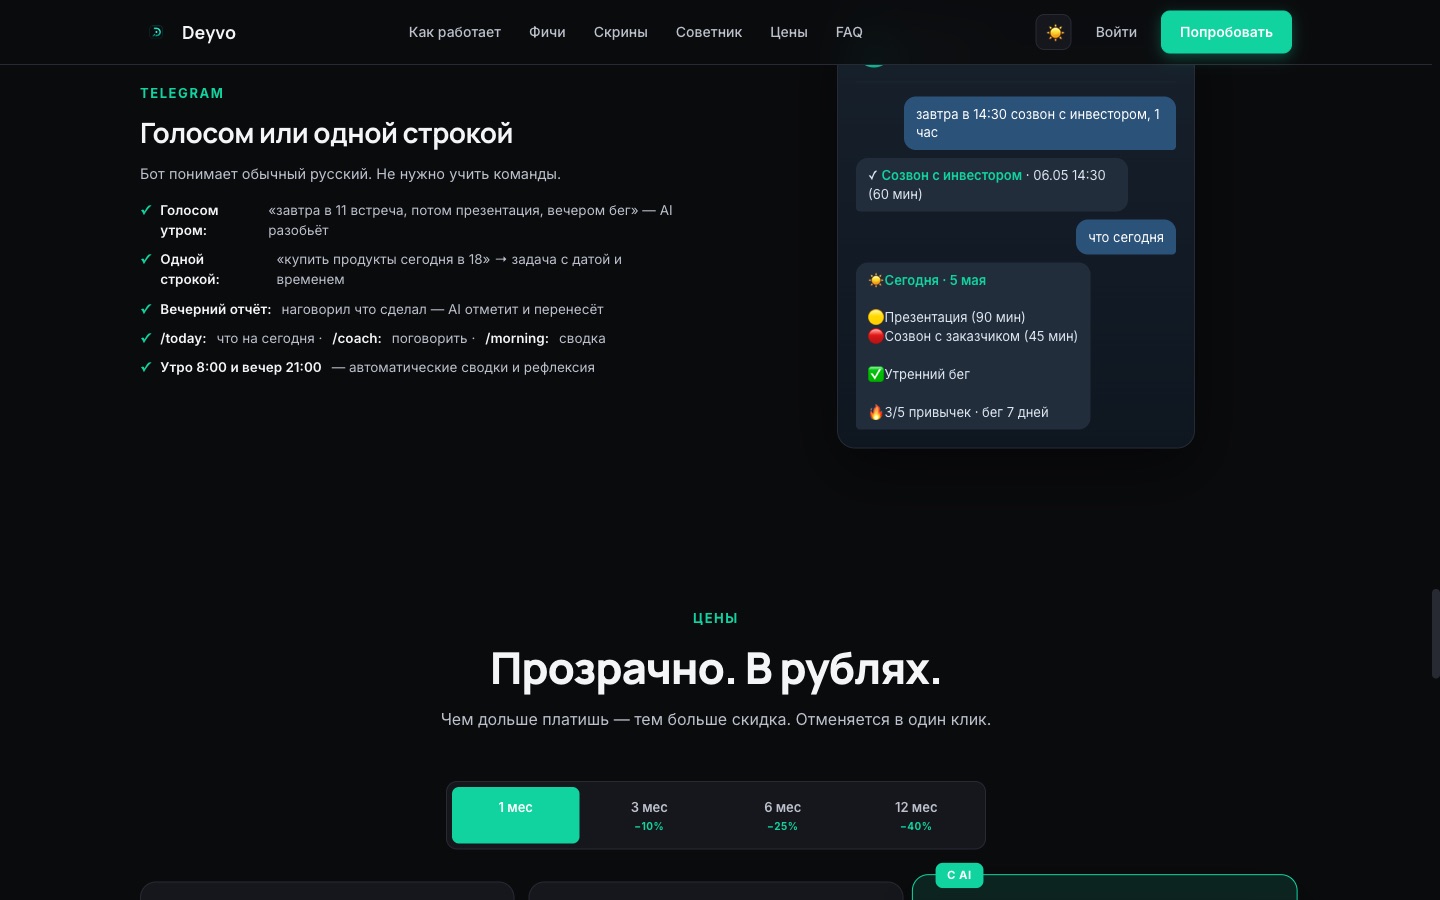
На другом экране Deyvo виден пример утренней сводки с конкретными делами пользователя. Поэтому для контроля полезно сверять не только факт доставки сообщения, но и то, что сводка относится к текущему дню и нужному аккаунту.
В «Лёд и Пламя» копия базы создаётся каждую ночь в 03:00 и хранится 30 дней. Отдельный сторож должен проверять свежесть копии: файл с вчерашней датой не доказывает, что сегодняшняя задача выполнилась. Если срок последней успешной копии вышел за согласованный предел, уведомление получает технический ответственный. Проверку восстановления проводят отдельно.
Для HIKITA CRM в стеке указаны Celery и Beat, которые готовят утренние сводки. Если работник запущен, но задачи застряли, простой сигнал «процесс жив» ничего не скажет владельцу. Нужен предел задержки и журнал последнего успешного задания. Число минут берут из обещания конкретного сервиса; переносить порог из чужого проекта нельзя.
| Рабочее обещание | Сигнал | Кому приходит |
|---|---|---|
| Форма приняла заявку | Запись появилась в рабочем списке | Ответственному за заявки |
| Бот обещал сводку | Последний успешный выпуск и доставка | Владельцу сервиса |
| Расписание обновилось | Новые данные видны в ответе | Администратору системы |
| Архив создаётся ежедневно | Копия свежая и проверяема | Техническому ответственному |
Как настроить оповещение без постоянного шума
Сигнал должен иметь проверяемое условие и адресата. Например, два последовательных неуспешных внешних запроса могут быть поводом открыть страницу вручную и посмотреть журнал. При восстановлении отправьте отдельное сообщение, иначе ответственный продолжит искать уже закрытый сбой. Для ошибки фонового процесса добавьте имя задания и время последнего успеха. Полный журнал разбирайте внутри проекта.
Проверьте сам канал оповещения. Отключите на тестовом контуре один безопасный маршрут или используйте заранее предусмотренный режим пробы. Убедитесь, что сообщение дошло, содержит адрес и время, а повторные одинаковые сигналы не забивают чат. Затем проверьте, что у команды есть короткий порядок действий: кто смотрит сервер, кто сообщает клиенту, кто принимает решение об откате. Если всё держится на памяти одного человека, мониторинг только быстрее обнаружит проблему, но не сократит время восстановления.
После пробного отказа сохраните короткую памятку для дежурного:
- Откройте адрес из сигнала снаружи сервера.
- Проверьте состояние службы и последние ошибки.
- Повторите безопасное действие пользователя.
- Назовите ответственного за исправление и сообщение клиенту.
Какие показатели хранить после инцидента
Для каждого сбоя сохраните начало, момент первого сигнала, момент ответа команды, причину и время восстановления. Этого достаточно, чтобы отличить проблемы обнаружения от проблем исправления. Если сигнал пришёл через минуту, а реакция началась через час, менять частоту опроса бессмысленно. Если клиент написал первым, проверьте, какой из трёх уровней наблюдения отсутствовал.
Перед следующей выкладкой повторите обычную проверку: аудит зависимостей, сборка, проба локального сервиса и публичная страница после доставки. Мониторинг показывает сбой, а надёжный процесс выкладки уменьшает число самих сбоев. На обучении такие проверки собираем вокруг реального действия пользователя, а затем намеренно проверяем, сработает ли сигнал при отказе одного звена.
Частые вопросы
Достаточно ли проверять главную страницу?
Нет, если продукт обещает форму, кабинет или сообщение бота. Добавьте проверку самого важного действия безопасным способом.
Нужен ли внешний мониторинг, если есть журнал сервера?
Да. При полной недоступности VPS его внутренний журнал сам уведомление не отправит. Внешняя проверка видит маршрут пользователя.
Зачем проверять диск, если сайт отвечает?
Заполненный диск может сначала остановить записи, журналы или копии, пока старые страницы продолжают открываться.
Какой интервал проверки выбрать?
По важности обещания и допустимой задержке. Повторные случайные сетевые ошибки не должны создавать ложную тревогу. Настоящий сбой при этом нужно замечать вовремя.
Что писать в сообщении о сбое?
Адрес или имя задания, время, наблюдаемый симптом и ссылку на порядок диагностики. Секреты и личные данные туда не включают.
Начните с одной публичной страницы и одного рабочего события. После тестового отказа будет ясно, получит ли команда сигнал до обращения клиента.