Парсинг сайтов: как собрать данные и проверить их до загрузки
Тем, кто хочет собрать открытые данные для своего сайта или внутреннего справочника
Последовательность от образца страницы до проверенной базы записей
8 мин
Данные переписали с нескольких страниц вручную, пропустили даты и создали дубли
У каждой записи есть адрес источника, обязательные поля и результат проверки
Практический порядок сбора данных с сайта: схема записи, извлечение, поиск дублей и ручная сверка результата.
Парсинг сайтов полезен, когда на страницах лежит повторяющийся набор сведений, который нужен вашему продукту: дата, название, описание, категория. Главная работа здесь состоит в определении правильной записи и поиске пропусков. Скачивание HTML только первый шаг. Скрипт может успешно пройти страницы и всё равно сохранить неправильный год, пустое название или два варианта одного события. Поэтому сначала задают схему данных и проверку результата, затем пишут извлечение.
Материалы для календаря собирались из открытых источников, включая azbyka.ru. Ниже показан порядок проверки записей. О подготовке документов для ответов ИИ я пишу в статье о базе знаний.
Как это выглядит в работе
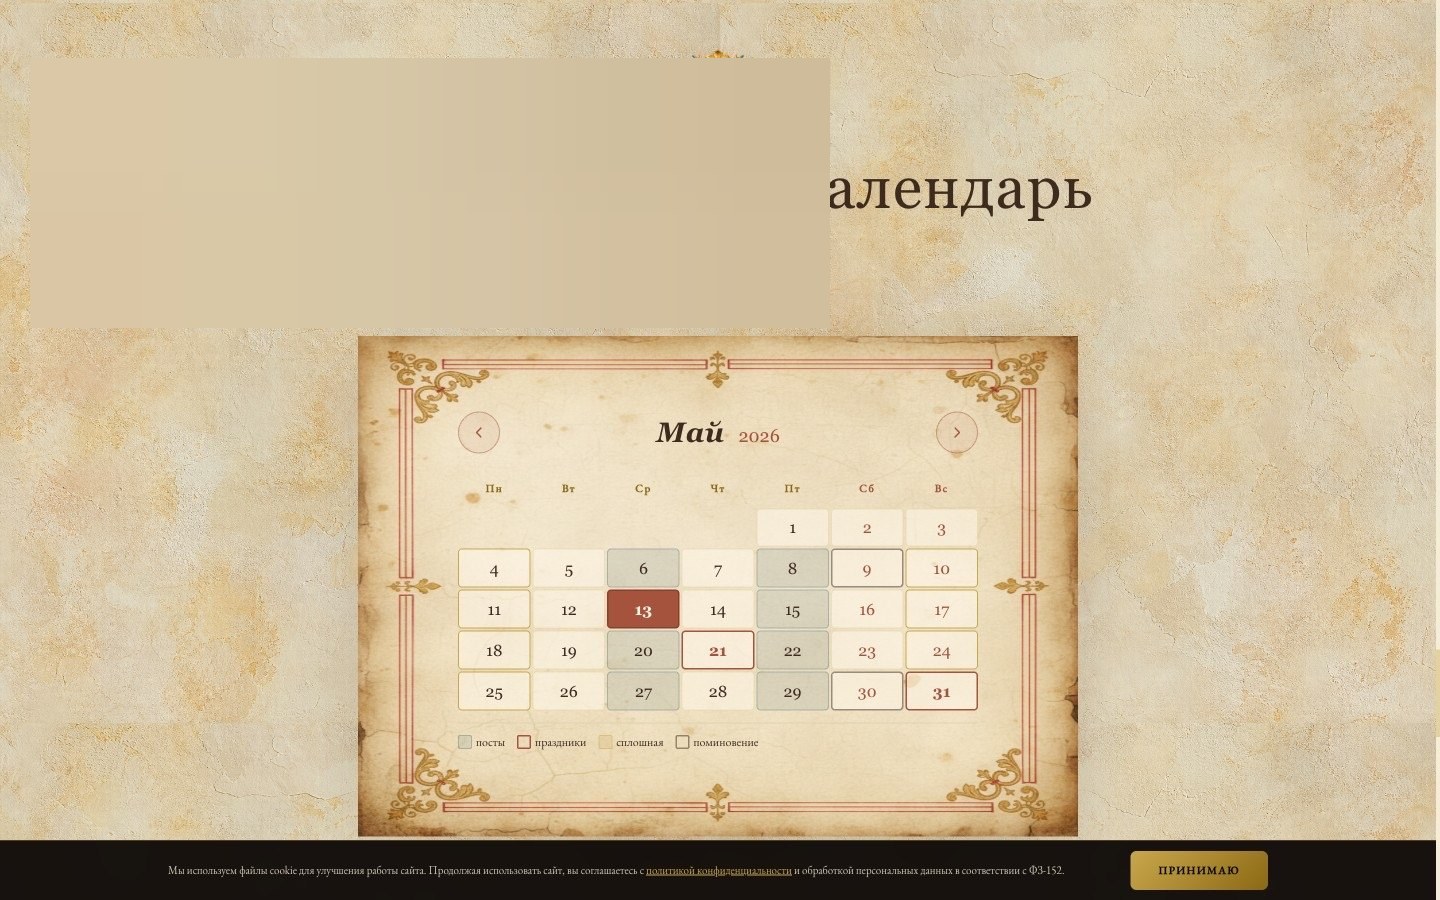
На экране календаря видны май 2026 года, выделенный день, цветовые обозначения постов и праздников и переключение месяцев. Это готовый результат обработки данных. Способ извлечения нужно проверять отдельно по исходным образцам и журналу сбора.
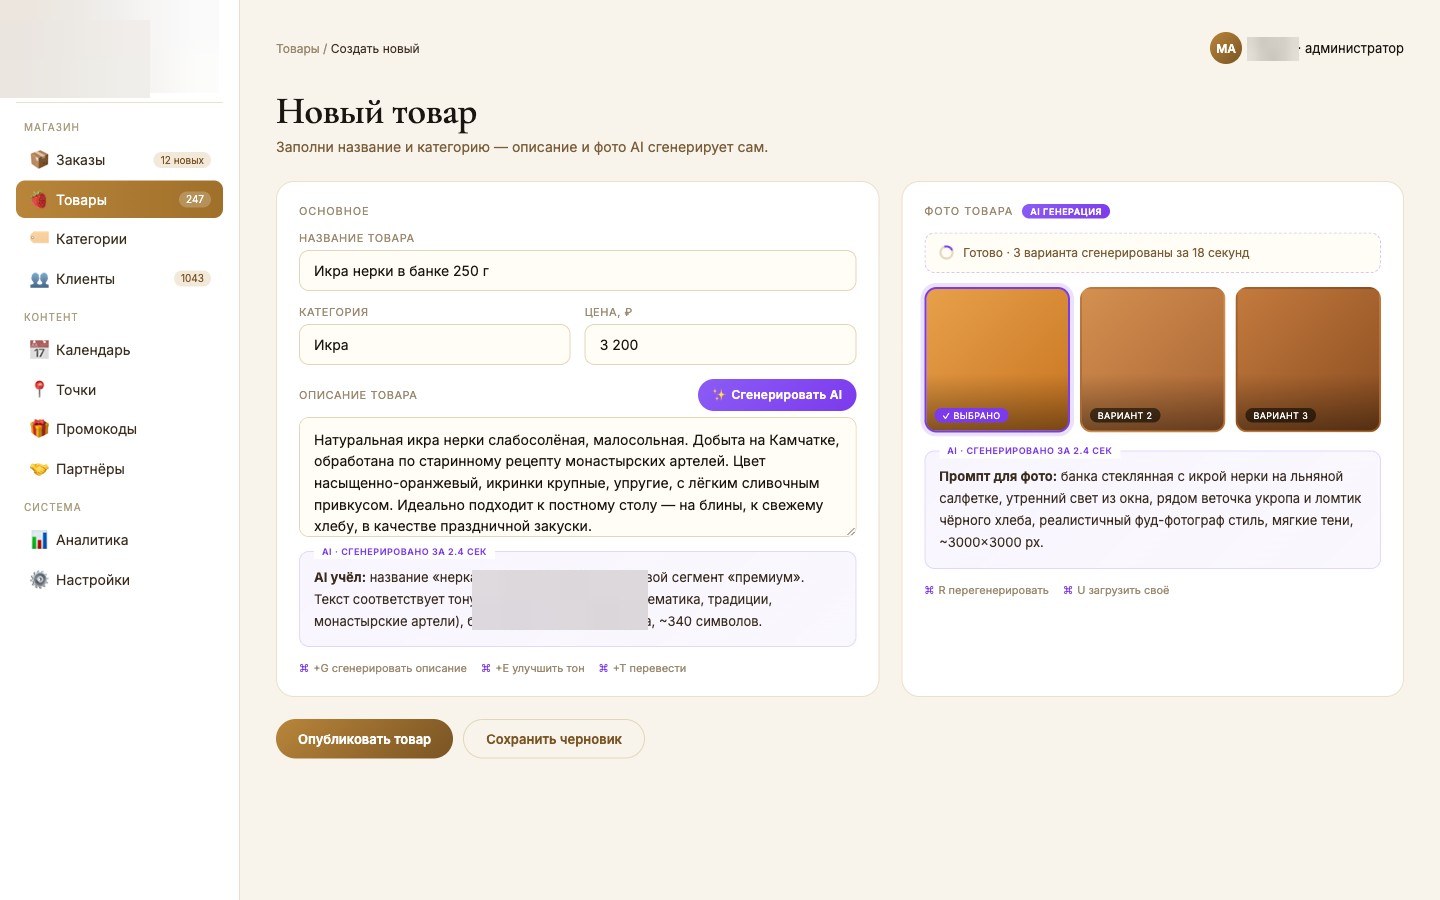
В админке того же проекта видны отдельные поля товара и пункт «Календарь» в меню контента. Такой интерфейс показывает, зачем после сбора нужен этап проверки и сохранения записей в управляемой структуре; данные календаря и товара имеют разные схемы.
Сначала определить одну запись
Откройте несколько разных страниц источника: обычную, длинную и с отсутствующим полем. Выпишите, что должно попасть в одну строку вашей базы. Для календаря единицей может быть календарная дата с типом дня и перечнем событий; это описание схемы задачи, не утверждение о точной структуре текущего сайта источника. Если день включает несколько записей, решите заранее, хранить их списком или отдельными связанными строками. Не заставляйте парсер принимать решение по расположению текста на экране.
У каждой записи сохраните исходный адрес и время получения. Когда редактор заметит ошибку через месяц, можно открыть первоисточник и понять, он изменился или ваш код извлёк не тот блок. Название страницы без адреса недостаточно: одинаковые заголовки встречаются у разных дат. Ключ записи должен быть устойчивым для вашей задачи, например дата плюс тип события, если этого достаточно по предметным правилам.
| Поле | Для чего нужно | Что считать ошибкой | Как проверять |
|---|---|---|---|
| Дата | Найти день и отсортировать | Неверный год или пустота | Диапазон и уникальность |
| Название | Показать человеку | Пустая строка или навигация сайта | Ручная выборка |
| Тип | Связать с фильтром | Неизвестное значение | Список разрешённых типов |
| Источник | Вернуться к первичной странице | Отсутствует адрес | Открыть несколько ссылок |
| Получено | Понять свежесть | Нет времени сбора | Журнал запуска |
Как найти данные до написания парсера
Посмотрите, что возвращает сама страница и её сетевые запросы. Иногда текст уже приходит в структурированном ответе; иногда находится только в HTML. Сравните несколько страниц, чтобы понять, повторяется ли форма данных. Не основывайте код на одном удачном экране. Если данные скрываются за входом или правила источника ограничивают получение, сначала разберитесь с разрешённым способом доступа и объёмом использования. Техническая возможность запросить адрес ещё не означает, что можно бездумно копировать весь чужой сайт.
До сбора проверьте соглашение сайта и robots.txt, соблюдайте обозначенные ограничения и делайте паузы между запросами, чтобы не перегружать источник. Закрытые и платные данные не трогайте; вход и капчу не обходите. Контакты конкретных людей относятся к персональным данным. Не собирайте их для такого справочника; случайно попавшие в результат затирайте. Если задача всё же требует таких сведений, отдельно определите основание и порядок обработки по 152-ФЗ до запуска сбора. Открытость страницы сама по себе не даёт разрешения сохранять чужие контакты.
Перед первым полным сбором проверьте маленькую выборку:
- Сохраните обычный и сложный ответ источника.
- Запишите обязательные поля одной записи.
- Сверьте результат разбора с исходной страницей.
- Проверьте, что повторный запуск обновляет запись без дубля.
Сохраните несколько образцов ответа локально. Тогда изменения в коде можно проверять на одинаковом входе и не нагружать источник каждым запуском теста. Полезно включить «сложные» образцы: пустой блок, несколько элементов, необычную дату. Укажите в заметке, когда образцы получены и что должен дать каждый. Если формат источника поменяется, вы увидите, где сломалось извлечение.
Отдельно получить, разобрать и сохранить
Разделите программу на три шага. Первый получает ответ и отмечает ошибку сети. Второй превращает ответ в записи по заданной схеме. Третий проверяет и сохраняет данные. Если всё спрятать в одну длинную функцию, при ошибке трудно понять, что произошло: сайт недоступен, изменилась разметка или запись не прошла проверку.
После получения проверяйте HTTP-статус и тип ответа. Страница с сообщением об ошибке тоже может вернуть HTML, а простой парсер примет её заголовок за название праздника. После разбора не записывайте пустые результаты как успешный день. Сохраняйте сырой образец или краткий журнал ошибки, чтобы восстановить причину. При повторном запуске запись с тем же ключом должна обновиться по понятному правилу. Дубликат указывает на ошибку ключа или сохранения.
| Этап | На входе | На выходе | Что останавливает запуск |
|---|---|---|---|
| Получение | Адрес страницы | Ответ и статус | Сеть, недоступный адрес |
| Разбор | Сохранённый ответ | Поля по схеме | Неизвестная структура |
| Проверка | Набор полей | Принятая запись | Пустое обязательное поле |
| Сохранение | Проверенная запись | Обновлённая база | Дубль или конфликт ключа |
Как проверить полноту календаря
В проекте «Православная Трапеза» календарь охватывает 365 дней годового круга. Само число 365 относится к показанному годовому набору и не служит универсальным правилом на любой год: в високосном году дней больше. Для вашего набора задайте ожидаемый диапазон дат и сравните с полученным. Потом проверьте уникальность ключей и несколько случайных дней глазами по исходным страницам. Отдельно откройте первый и последний день диапазона, а также даты, где парсер сообщил об ошибке.
Ниже условный пример проверки уже подготовленного файла calendar.json. Он не показывает код извлечения из сайта клиента. Предполагается список объектов с полем date в формате YYYY-MM‑DD. Подставьте собственные поля и диапазон; сначала сохраните копию файла, который проверяете.
import json
from collections import Counter
from pathlib import Path

rows = json.loads(Path("calendar.json").read_text(encoding="utf-8"))
dates = [row.get("date") for row in rows]
counts = Counter(dates)
missing_values = sum(not date for date in dates)
duplicates = [date for date, count in counts.items() if date and count > 1]
print("записей:", len(rows))
print("без даты:", missing_values)
print("дубли дат:", duplicates[:20])
Эта проверка ищет только пустые даты и дубли. Она не доказывает, что охвачен весь год и что описание верное. Для полноты сравните набор дат с ожидаемым календарём, а для содержания проведите ручную сверку первоисточника. Если на одну дату допустимо несколько событий, проверяйте составной ключ из даты и события. Схема данных определяет проверку.
Как не потерять происхождение изменений
Источник может поправить страницу после вашего сбора. Если ваш сайт показывает сохранённую копию, нужен порядок обновления: что обновляется автоматически, что проходит редакторскую проверку и когда новая версия попадает к посетителю. Для справочника с фактами лучше хранить дату получения и источник каждой записи. Когда изменяется текст, можно показать редактору разницу вместо молчаливой перезаписи. Если запись уже связана с заказом, исторический смысл этого заказа не должен зависеть от свежей страницы источника.
Проверьте ещё и отображение. Дата может быть сохранена правильно, но на сайте показана на предыдущий день из‑за преобразования часового пояса. Название может содержать невидимый пробел, из‑за которого поиск не находит запись. Ищите весь класс ошибки: получение, хранение, фильтр и страница. Парсер, который выдал правильный JSON, ещё не гарантирует правильный интерфейс.
Частые вопросы
Достаточно ли попросить ИИ «спарсить сайт»?
Нет. Дайте образцы страниц, схему записи, правила пропусков и критерии проверки. Иначе агент может собрать красивый файл с неверным содержанием.
Нужно ли каждый раз скачивать все страницы заново?
Это зависит от частоты изменений источника. Для стабильного справочника можно обновлять по расписанию с журналом изменений; конкретный режим выбирайте по источнику и задаче.
Что делать, если структура страницы изменилась?
Остановить запись неполных данных, сохранить пример нового ответа и поправить разбор. После этого прогнать прежние и новые образцы.
Можно ли считать запись без источника готовой?
Для внутреннего черновика её можно пометить как требующую проверки. Для публичного факта отсутствие происхождения затруднит исправление ошибки.
Почему записи дублируются после повторного запуска?
Обычно не определён устойчивый ключ либо сохранение всегда добавляет строку. Проверьте правило обновления существующей записи и состав ключа.
На обучении самостоятельной сборке можно разобрать один ваш источник: определить запись, собрать небольшой образец, проверить пропуски и только затем расширять сбор.